
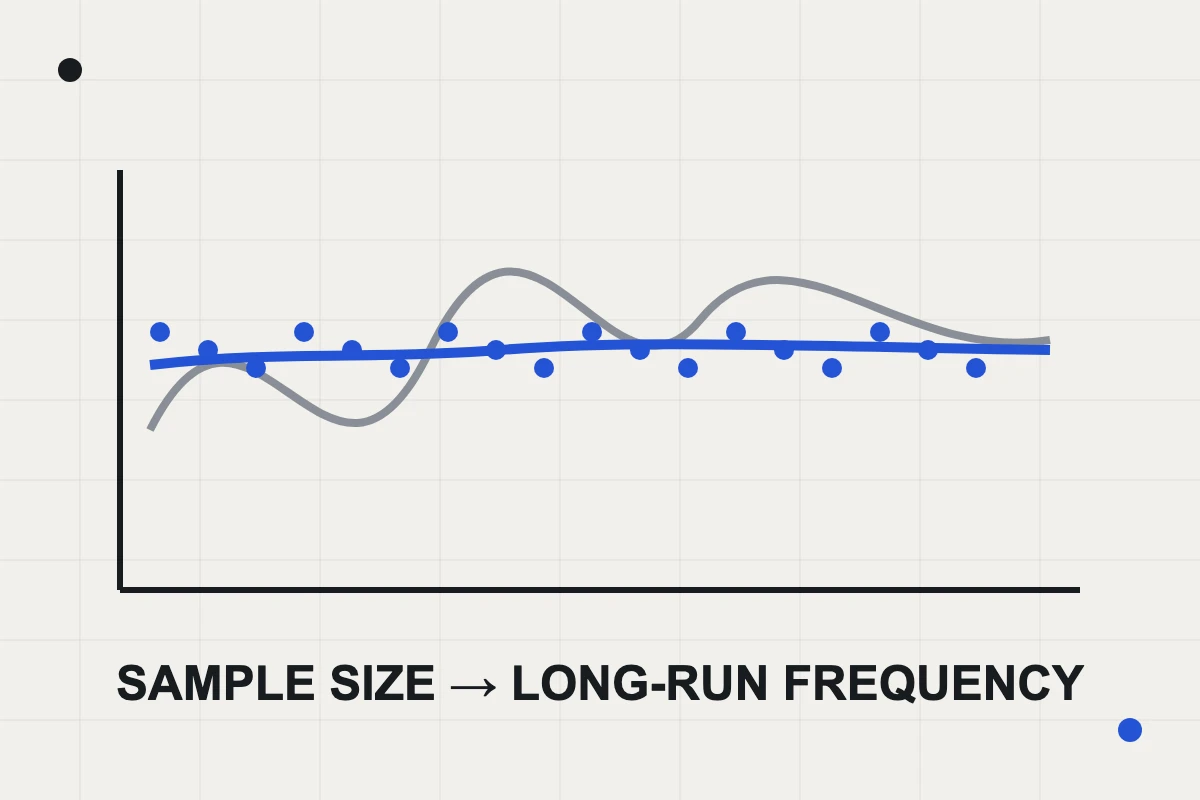
เวลาเห็นสถิติว่า “เลขนี้ออก 4 ครั้งใน 20 งวด” กับ “เลขนี้ออก 400 ครั้งใน 2,000 งวด” ตัวเลขทั้งสองอาจมีสัดส่วนเท่ากัน แต่หลักฐานไม่ได้มีน้ำหนักเท่ากันครับ เพราะ Sample Size หรือขนาดตัวอย่าง ต่างกันมาก
ประเด็นสำคัญคือข้อมูลระยะสั้นสามารถแกว่งจากค่าเชิงทฤษฎีได้มากโดยไม่แปลว่ากระบวนการสุ่มผิดปกติ และการมีข้อมูลมากขึ้นช่วยให้เราอธิบายความถี่ในอดีตได้เสถียรขึ้น แต่ไม่ได้เปลี่ยนประวัติให้เป็นคำทำนายงวดถัดไป
Sample Size คืออะไร
Sample Size คือจำนวนข้อมูลหรือจำนวนครั้งทดลองที่เราใช้คำนวณสถิติ ถ้าดู 20 งวด ขนาดตัวอย่างคือ 20 ถ้าดู 2,000 งวด ขนาดตัวอย่างคือ 2,000
เมื่อจำนวนข้อมูลน้อย การเพิ่มหรือลดเพียงไม่กี่ครั้งทำให้เปอร์เซ็นต์เปลี่ยนแรงได้ เช่น 1 ครั้งจาก 10 คือ 10% แต่เพิ่มอีกเพียงครั้งเดียวกลายเป็น 20%
Relative Frequency คืออะไร
Relative Frequency หรือความถี่สัมพัทธ์ คือจำนวนครั้งที่เหตุการณ์เกิด หารด้วยจำนวนครั้งทั้งหมด
ถ้าเหตุการณ์ A เกิด 8 ครั้งจาก 40 ครั้ง:
Relative Frequency = 8 / 40 = 20%
ตัวเลข 20% นี้บอกสิ่งที่เกิดในตัวอย่าง 40 ครั้ง ไม่ได้แปลว่าเราได้พิสูจน์ว่าความน่าจะเป็นจริงของ A เท่ากับ 20% แล้ว
กฎจำนวนมากพูดว่าอะไร
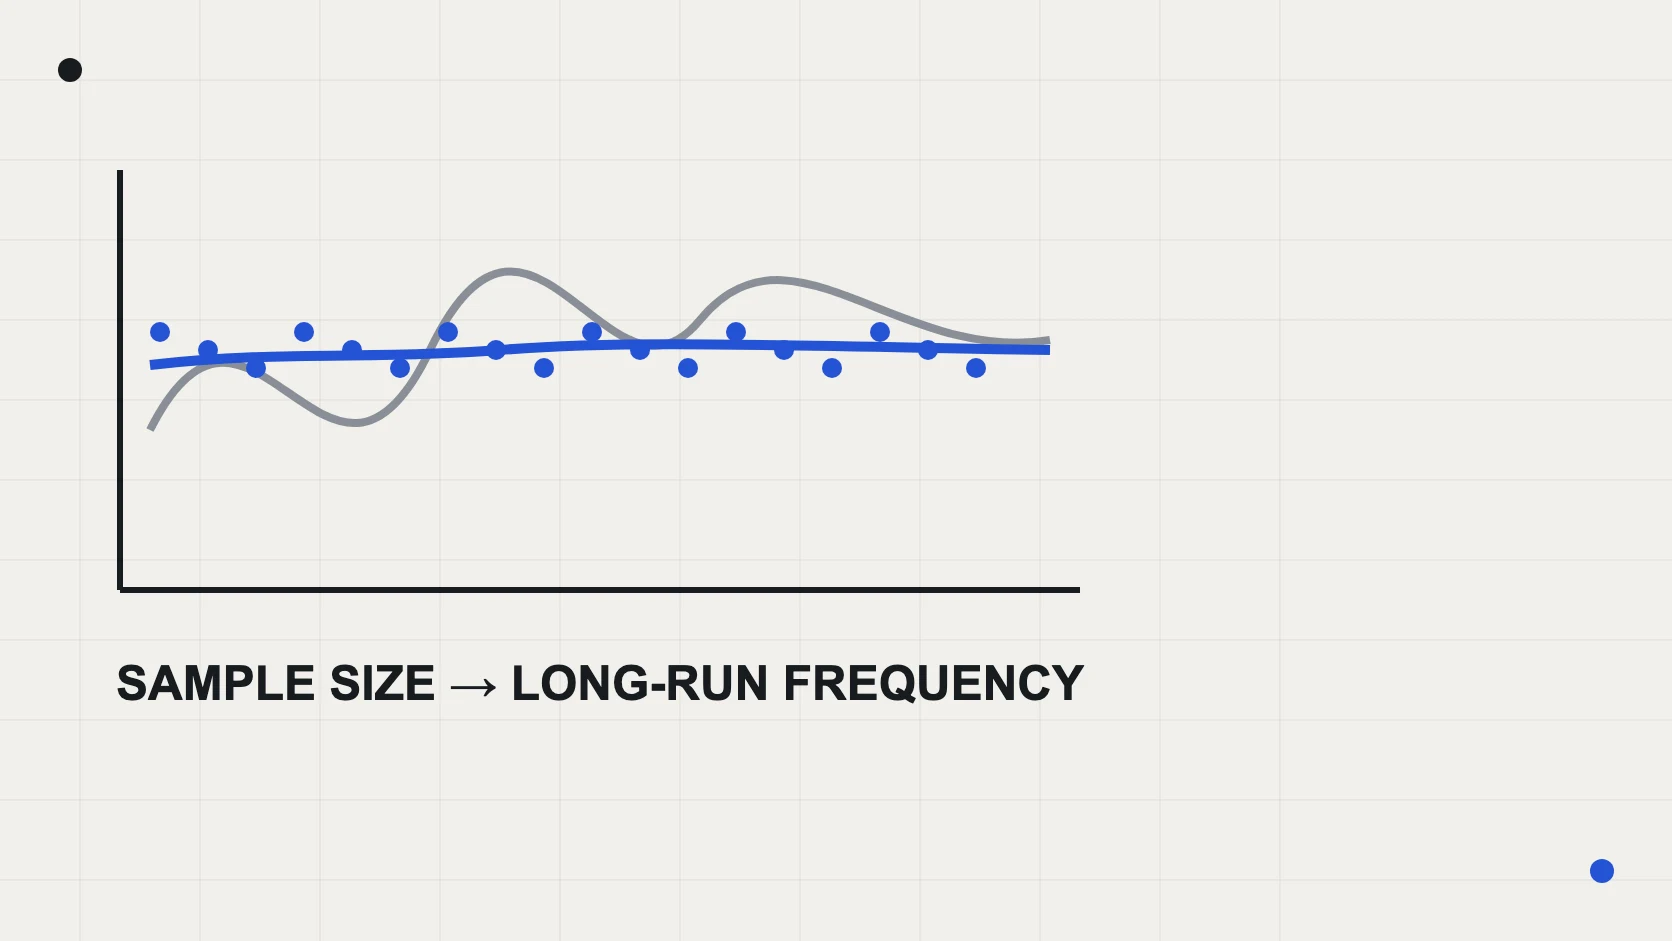
OpenStax อธิบาย Law of Large Numbers ว่า เมื่อจำนวนครั้งทดลองในกระบวนการความน่าจะเป็นเพิ่มขึ้น ความถี่สัมพัทธ์มีแนวโน้มเข้าใกล้ความน่าจะเป็นเชิงทฤษฎีมากขึ้น
คำว่า “มีแนวโน้มเข้าใกล้” สำคัญมาก เพราะไม่ได้หมายความว่าหลังครบจำนวนหนึ่งแล้วสัดส่วนต้องเท่ากับค่าทฤษฎีเป๊ะ และไม่ได้บังคับว่าทุกช่วงสั้นต้องสมดุล
ตัวอย่างเหรียญช่วยให้เห็นภาพ
สมมติเหรียญยุติธรรมมีโอกาสหัว 50% ต่อครั้ง
โยน 4 ครั้งแล้วออกหัว 3 ครั้ง เราเห็น Relative Frequency = 75% ซึ่งห่างจาก 50% มาก แต่ไม่ได้ทำให้โอกาสหัวของการโยนครั้งถัดไปกลายเป็น 25% เพื่อ “ชดเชย”
เมื่อทดลองซ้ำจำนวนมาก สัดส่วนหัวโดยรวมมีแนวโน้มใกล้ 50% มากขึ้นภายใต้สมมติฐานเดิม นี่เป็นเรื่องของภาพรวมระยะยาว ไม่ใช่ระบบที่จัดคิวให้ผลรอบถัดไป
ถ้ายังสงสัยเรื่อง “ถึงคิวหรือยัง” อ่าน เหตุการณ์อิสระ ก่อนครับ
ทำไม 20 งวดทำให้แพตเทิร์นดูเด่นง่าย
เพราะแต่ละผลมีน้ำหนักต่อเปอร์เซ็นต์สูงกว่าในตัวอย่างใหญ่ และเรายังมีอิสระเลือกช่วงเวลาได้หลายแบบ
เช่น ถ้าดู 20 งวดล่าสุด อาจเห็นเลขหนึ่งเด่น แต่ขยายเป็น 100 งวดภาพเปลี่ยน แล้วขยายเป็น 1,000 งวดอาจเปลี่ยนอีกครั้ง การเลือกช่วงหลังเห็นผลแล้วทำให้เราเจอช่วงที่ “ดูน่าสนใจ” ได้ง่ายขึ้น
นี่ไม่ได้แปลว่าข้อมูล 20 งวดไม่มีประโยชน์ แต่ต้องระบุชัดว่ากำลังอธิบายช่วงไหนและมีข้อมูลกี่รายการ
ข้อมูลมากขึ้นทำให้งวดหน้าทำนายง่ายขึ้นไหม
ไม่โดยอัตโนมัติครับ ถ้ากระบวนการแต่ละงวดเป็นอิสระและความน่าจะเป็นพื้นฐานไม่เปลี่ยน ประวัติจำนวนมากช่วยให้ประเมินพฤติกรรมระยะยาวหรือเช็กความสอดคล้องกับแบบจำลองได้ดีขึ้น แต่ยังไม่ได้สร้างข้อมูลเกี่ยวกับผลเฉพาะงวดถัดไป
ข้อมูลเยอะกับ “ทำนายได้” เป็นคนละประโยค ต้องมีเหตุผลว่ากระบวนการอนาคตสัมพันธ์กับข้อมูลอดีตอย่างไรจึงจะเชื่อมกันได้
เวลาอ่านสถิติย้อนหลัง ควรบันทึกอะไร
อย่างน้อยควรมี:
- ช่วงวันที่หรือช่วงงวด
- จำนวนข้อมูลทั้งหมด
- นิยามของเหตุการณ์ที่นับ
- แหล่งข้อมูล
- กติกาของเกมในช่วงนั้น
- วิธีจัดการงวดที่ข้อมูลหายหรือกติกาเปลี่ยน
ถ้าเปลี่ยนช่วงข้อมูลแล้วข้อสรุปเปลี่ยนแรง ควรบอกให้ผู้อ่านเห็น ไม่ควรเลือกเฉพาะหน้าต่างที่ทำให้แพตเทิร์นชัดที่สุด
Sample Size กับเลขซ้ำเกี่ยวกันอย่างไร
บท เลขออกซ้ำ คำนวณโอกาสจากโครงสร้างเกมโดยตรง ส่วน Sample Size ใช้ตอบอีกคำถามว่า เมื่อเราเก็บผลจริงจำนวนหนึ่ง ความถี่ที่สังเกตได้ควรถูกตีความอย่างไร
สูตรความน่าจะเป็นไม่ได้ถูกแทนที่ด้วยจำนวนงวด และจำนวนงวดก็ไม่ได้กลายเป็นสูตรทำนาย
อ่านต่อ Expected Value
เมื่อเข้าใจว่าค่าเฉลี่ยระยะยาวต้องอาศัยการทดลองจำนวนมากแล้ว ขั้นถัดไปคือ Expected Value ซึ่งถามว่า ถ้าให้น้ำหนักผลลัพธ์แต่ละแบบด้วยความน่าจะเป็น ค่าเฉลี่ยระยะยาวของตัวแปรนั้นเป็นเท่าไร
คำถามที่พบบ่อย
ข้อมูล 2,000 งวดดีกว่า 20 งวดเสมอไหม?
ถ้าคำถามและกติกาเหมือนกัน ข้อมูลมากขึ้นมักช่วยลดความแกว่งของความถี่สัมพัทธ์ แต่ต้องตรวจด้วยว่าช่วงยาวนั้นมีการเปลี่ยนกติกาหรือแหล่งข้อมูลหรือไม่
กฎจำนวนมากแปลว่าเลขที่ไม่ออกต้องออกมาชดเชยไหม?
ไม่ กฎจำนวนมากพูดถึงพฤติกรรมของสัดส่วนเมื่อจำนวนการทดลองเพิ่ม ไม่ได้สร้างคิวชดเชยให้ผลรอบถัดไป
สถิติย้อนหลังยังมีประโยชน์หรือไม่?
มีประโยชน์ในการอธิบายสิ่งที่เกิดขึ้น ตรวจคุณภาพข้อมูล และเปรียบเทียบกับแบบจำลอง แต่ไม่ควรยกระดับเป็นคำทำนายโดยไม่มีเหตุผลเพิ่มเติม